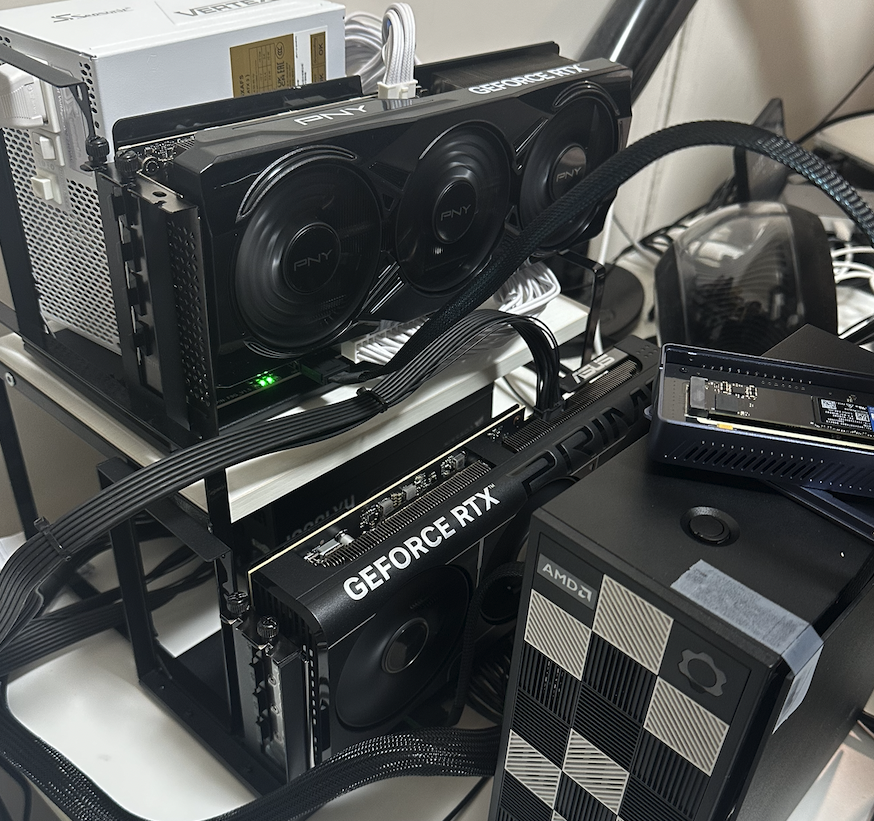
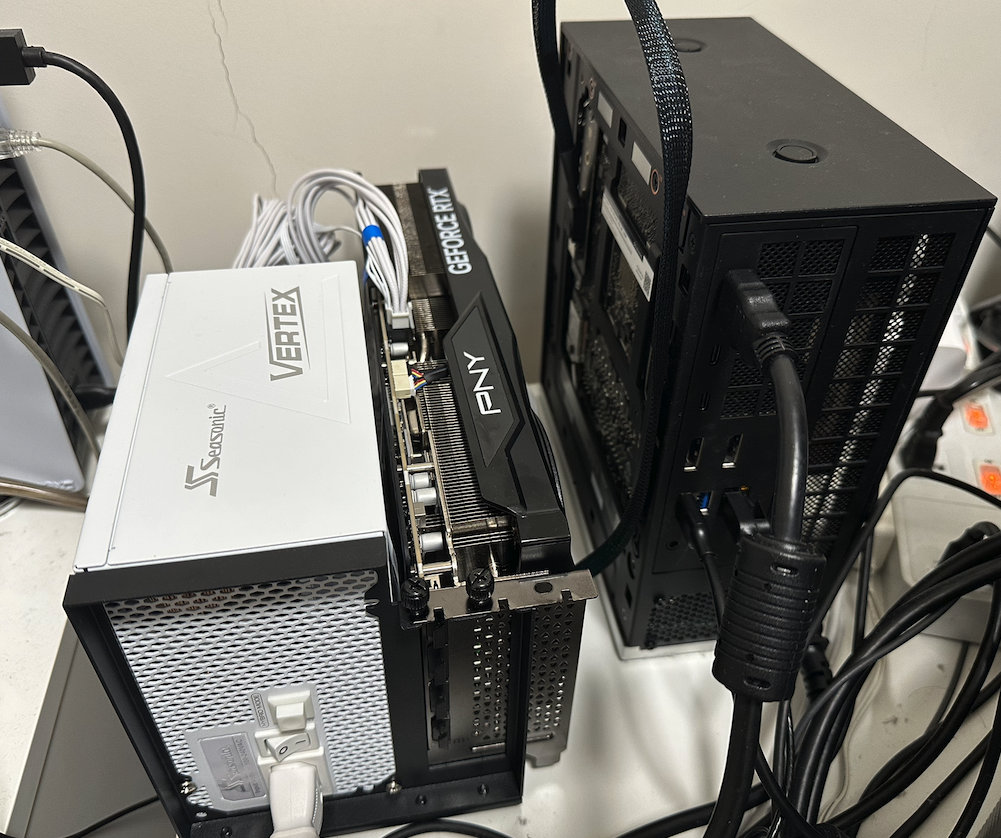
相比跑 LLM,我認為跑 Embedding、Reranker、Decision Model 在地端用來開發 AI 應用更大有可為,用 5070Ti、5080 消費級高階顯示卡來跑就足夠快(甚至比呼叫雲端 API 還快了),已經能滿足 production 應用的需求。而且雖然顯卡 ram 不多,但因為這類模型夠小,一張卡就放得下,因此可以很容易就透過多張卡平行跑來提高吞吐量跟速度。
例如,RAG 匯入新文件時,需要一次產生大量 Embeddings,就可以把資料分給兩張卡,各自計算。Reranker 一次要重排 100 筆文件,也可以拆成兩批平行處理,最後再合併分數排序即可。Decision Model 每筆判斷彼此獨立,也能用同樣的方式分工。
例如,最近也在做 AI 推薦系統,會用到 PyTorch 等深度學習模型訓練。這種記憶體需求不算大,但若有 CUDA 支援,開發上會很有幫助,而且 production 最後也是 Nvidia GPU 環境。另外就是跑小模型例如 Embeddings、Reranker、OCR 或 ASR 語音辨識的話,其實記憶體需求也不大,但算力夠快會很有效益,可以多做即時語音辨識應用。這幾個任務我最後用 5070 Ti 大約會比 AMD gfx1151 快 3至4 倍,還是非常有感。
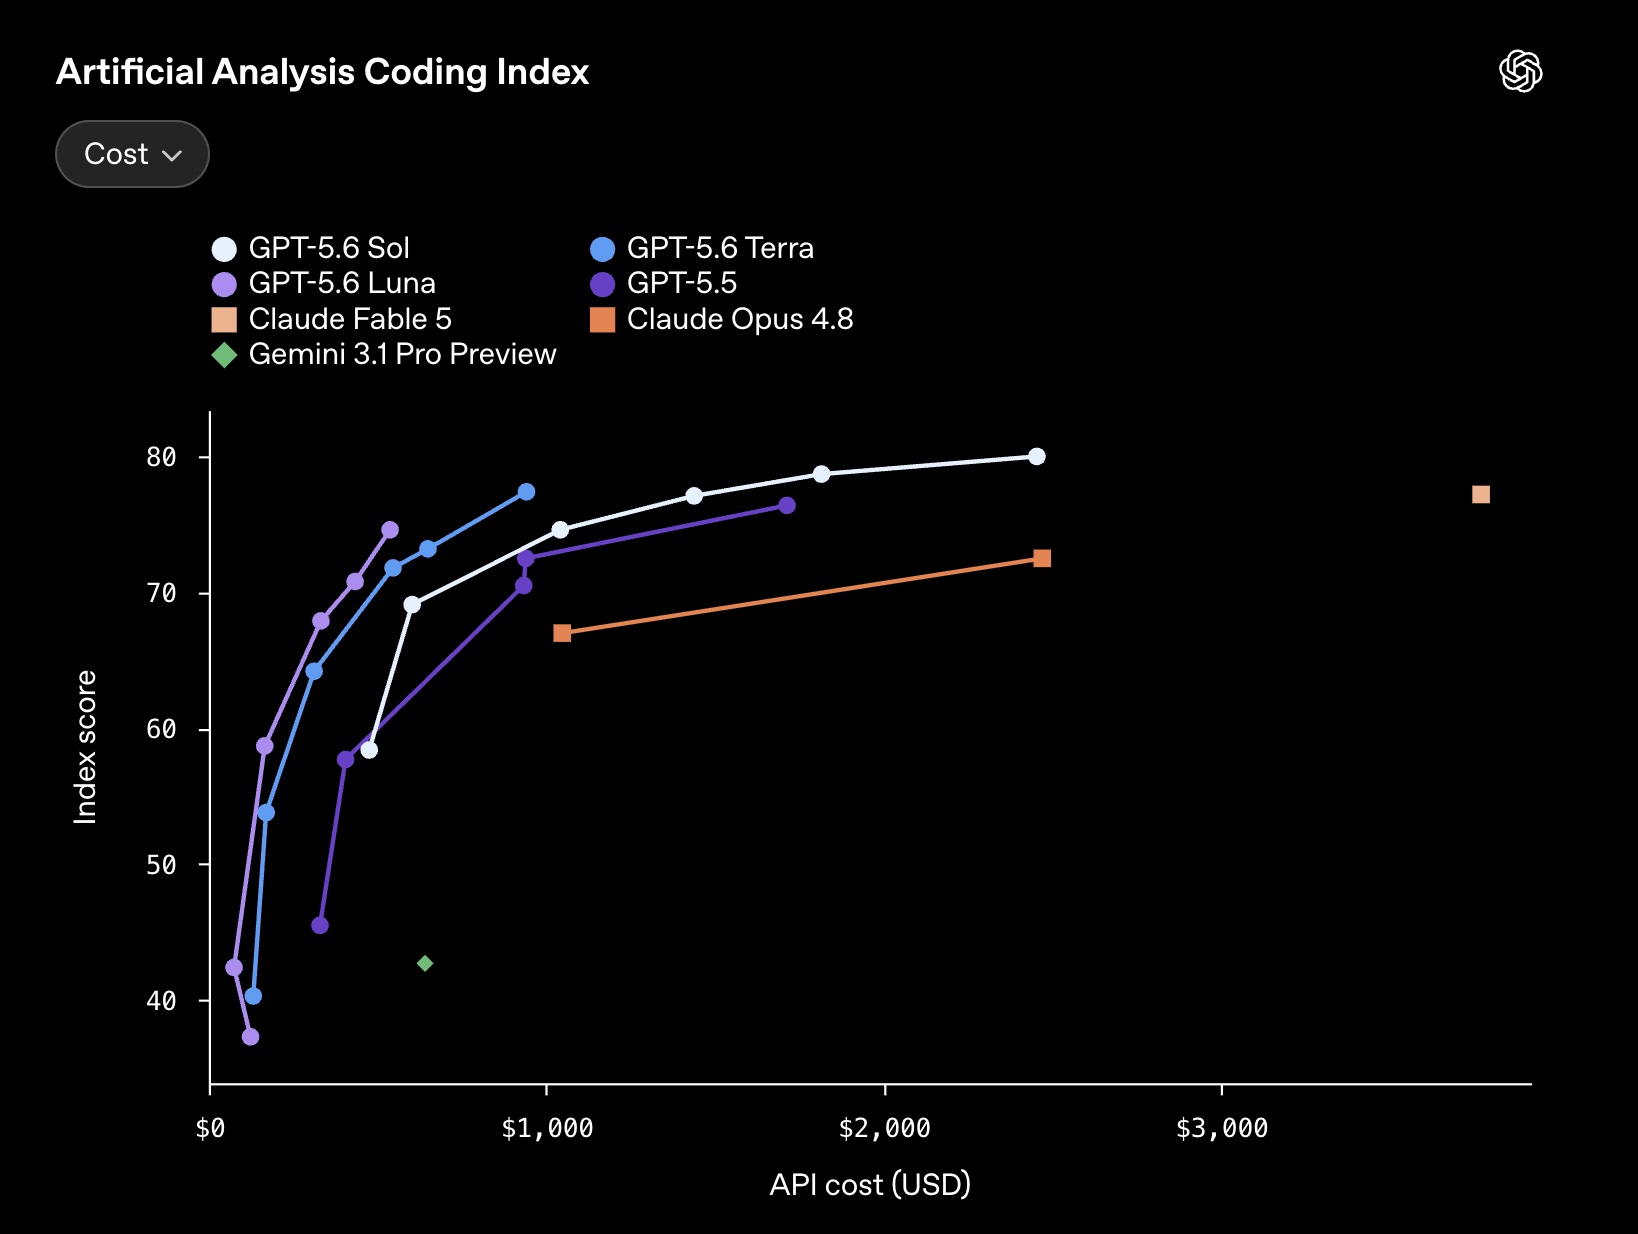
有趣的是,從官方公布的 Artificial Analysis Coding Index 可以看到,隨著 reasoning.effort 提高,Luna 或 Terra 可以超越高一級模型的低推理設定。模型選擇因此變成兩個維度:要選多大的模型,以及願意讓它思考多久。這也讓多模型調度更有發揮空間。如果是非用戶即時的任務 latency 不重要時,可以考慮多用 Luna 模型把推理程度調高,以此來節省成本。
📊 社群風向: Claude 4.7 不如預期,GPT-5.5 好評 + Codex App 繼續大爆發 — Claude Opus 4.7 四月中出來後,社群體感覺得沒有明顯提升,甚至有退步的聲音。更讓 API 用戶不滿的是,4.7 換了新的 tokenizer,相同的輸入會產生多 20–45% 的 tokens(官方說法是 1.0–1.35x,Simon Willison 實測最高到 1.47x)。雖然每 token 單價沒變,但實際帳單是變貴的,OpenRouter 真實流量分析顯示成本增加 12–27%,等於是隱性漲價(分析1、2)。相比之下 GPT-5.5 評價普遍正面,Codex App 搭配 GPT-5.5 之後實用性再上一個台階,兩家競爭越來越激烈了。
🪦 OpenAI API 關閉 fine-tuning 模型微調功能,至於 Claude API 從頭到尾都沒提供,Gemini API 曾經有但現在也關閉了(要在 Vertex AI 裡面還可以微調舊的 Gemini 2.5)。 對多數 AI 工程來說, 微調從來就不是主流路線。做 prompt/context/harness engineering 幾乎就夠忙了。 如果需要微調的話,現在只能用開源模型了。(我的觀察)